電子書籍をPDF化・OCR変換する完全ガイド|2026年版・無料アプリ対応5サービス徹底解説
「Kindleで買った本をiPadのPDFとして保存したい」「Koboの電子書籍をテキスト化して論文作業に使いたい」――こうした声は、電子書籍ユーザーの間で根強く存在する。2026年現在、国内の電子書籍市場は年間6,000億円規模(インプレス総研2025年度調査)に成長し、利用者数は推定5,200万人を超える。しかし、購入したコンテンツを自分の環境で自由に活用できないという「囲い込みの壁」は、依然として多くのユーザーを悩ませている。本記事では、KindleやKobo、DMMブックスをはじめとする主要5サービスの電子書籍をPDF化・OCR変換する具体的な手順と、2026年時点で実際に動作する無料アプリの選び方を、法的観点も含めて徹底解説する。
ただし、最初に断っておかなければならないことがある。電子書籍の変換作業には、著作権法や利用規約との関係で「合法」と「違法」の境界線が存在する。この線引きを理解せずにツールを使えば、思わぬリスクを負う可能性がある。本記事はその境界線を正確に示しながら、読者が安全に、かつ実用的に電子書籍を活用するための決定的な情報を提供する。
📌 【この記事の重要ポイントまとめ】---
- 要点1:電子書籍のPDF化・OCR変換には「DRM解除を伴う方法」と「スクリーンキャプチャ方式」の大きく2種類が存在し、合法性の判断が異なる。
- 要点2:2026年時点でKindle・Kobo・DMMなど5サービスに対応する無料ツールとして、自動キャプチャ型アプリ・Calibre・OCRソフトの組み合わせが最も現実的な選択肢となっている。
- 要点3:個人利用の私的複製を前提としたバックアップ目的であっても、DRM(技術的保護手段)の回避を伴う行為は著作権法第30条の適用外となる可能性があり、事前の法的理解が不可欠。
【2026年最新】電子書籍PDF化の全体像|どのアプローチが自分に合うか
電子書籍をPDF化・OCR変換する方法は、大きく分けて3つのアプローチが存在する。それぞれの仕組みと特徴を把握しておくことが、ツール選択の前提として不可欠だ。
① 自動スクリーンキャプチャ方式:電子書籍アプリを自動操作し、ページごとに画面をキャプチャしてPDFに結合する方法。DRMには干渉しないため、利用規約上のグレーゾーンはあるものの、著作権法上の技術的保護手段の回避には該当しないケースが多い。2025年末にリリースされた国産ツール「kin」(開発者:lytton氏)がこのカテゴリの代表例で、Noteでの公開記事によるとKindle・Kobo・DMMブックスなど5サービスに対応しており、余白自動トリミング・OCR・Markdown変換まで一気通貫で処理できるWindows専用の無料アプリだ。
② DRM解除+フォーマット変換方式:Calibre等のソフトウェアにDRM解除プラグインを組み合わせ、EPUBやAZW3ファイルを直接PDFへ変換する方法。技術的保護手段の回避を伴うため、日本の著作権法第30条第2項および第113条第2項に抵触するリスクがある。個人的な利用であっても法的に問題となる可能性を否定できない点を強調しておく。
③ 印刷・仮想プリンタ方式:一部の電子書籍サービスが提供するブラウザ閲覧機能や、印刷許可が設定されたPDFコンテンツを仮想プリンタ経由でPDF保存する方法。サービスが明示的に許可している場合のみ完全に合法。
epubor.com(日本語版ガイド、2026年9月更新)によると、Kindle本のPDF変換には「Calibreを使った無料変換」「オンラインコンバーターを使った無料変換」「Epubor UltimateによるDRMつきの縦書きPDF化」という3つの主要ルートが現在も案内されている。ただし同サイトが案内するDRM解除を伴う手順については、日本の法律環境との整合性を個別に確認することを強く推奨する。
---【サービス別・完全手順解説】Kindle・Kobo・DMMなど5サービス対応の方法
① Amazon Kindle|自動キャプチャ+OCR変換の実践手順
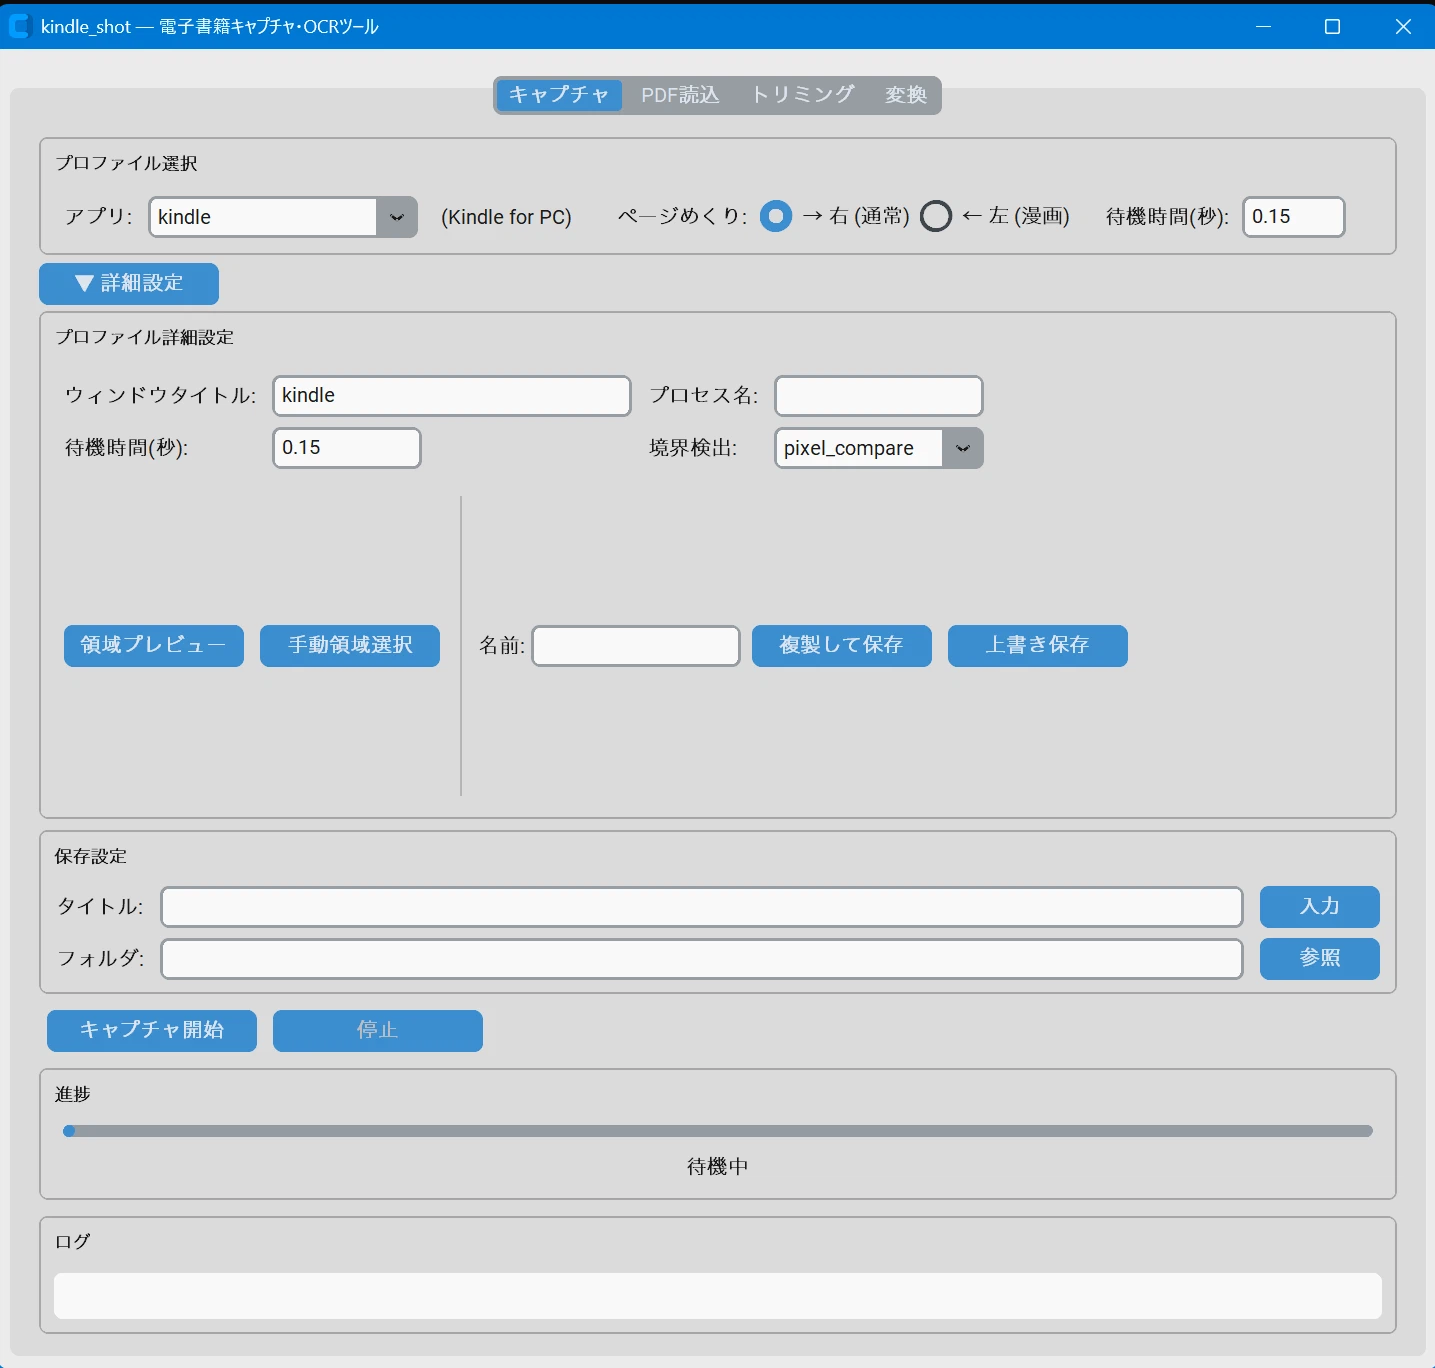
Kindleの電子書籍は、AZW3またはKFX形式で配信されており、独自のDRM(Kindle DRM)が施されている。2026年時点では、KindleアプリのPC版(Windows/Mac)を起動し、自動キャプチャツールで逐次スクリーンショットを取得する方法が、技術的保護手段への干渉を避けながら実用的なPDFを生成できる最も現実的な手段だ。
具体的な流れとしては、まずKindle for PCまたはKindle for Macを最新バージョンにアップデートし、対象書籍をPCにダウンロードしておく。次に自動キャプチャツール(後述する「kin」アプリ等)を起動し、キャプチャ対象ウィンドウとしてKindleアプリを指定する。ページ送りの間隔(推奨:1.2〜2.0秒)を設定したうえで処理を開始すると、ツールが自動でページをめくりながら全ページをキャプチャし、余白のトリミング・PDF結合・OCR処理(日本語テキスト認識)まで自動で行う。lytton氏がNote(2025年公開)で詳述しているように、このアプリは「コピペ作業の完全自動化」をコンセプトとして設計されており、研究・学習用途での利便性が高い。
② 楽天Kobo|EPUB形式の特性を活かした変換手順
Koboの電子書籍はEPUB形式を採用しており、Kindle系と比較するとオープンな規格に近い。ただしADEP(Adobe Digital Editions Protection)によるDRMが施されているため、直接的なファイル操作は制限される。
合法的な範囲での対処としては、楽天Koboの「kobo Desktop」アプリをPC上で起動し、前述の自動キャプチャツールでページごとに取得する方法が現実的だ。Koboはページ送りのアニメーションが比較的シンプルなため、自動キャプチャとの相性が良い。ページ送りインターバルは1.0〜1.5秒でも安定して動作するケースが多い。
Calibreについては、DRM解除プラグインを使わない「素の状態」でも、DRMフリーのEPUB(自分でDRM解除済みのもの、または購入時からDRMフリーで提供されているもの)のPDF変換ツールとして高い完成度を持つ。Calibre 7.x系(2026年版)では日本語EPUBのPDF変換精度が大幅に改善されており、縦書きレイアウトのサポートも強化されている。
③ DMMブックス|OCR変換に強いアプリとの組み合わせ
DMMブックスはマンガ・ライトノベル・一般書を幅広くカバーするサービスで、配信形式はブラウザビューワ型が中心だ。このため、ブラウザ上でのスクリーンキャプチャ自動化が主要なアプローチとなる。Chrome拡張機能と連携した自動スクロールキャプチャや、前述のkinアプリのDMMブックス対応モードを活用する方法が実用的だ。
OCR変換の精度については、DMMブックスで多いマンガ・コミック形式(吹き出しや縦書き混在)は認識難易度が高い。後述するOCRソフトの比較表を参考に、日本語縦書き・ふりがな対応のエンジンを選択することが重要だ。
④ BookLive!|セキュアな閲覧環境下での実用的対応
BookLive!はDMM同様にブラウザビューワを採用しており、自動キャプチャツールの対応可否はビューワのDOM構造とレンダリング速度に依存する。2026年時点では、lytton氏のkinアプリがBookLive!の自動キャプチャに部分対応(ページ送りのDOM操作を利用)しているが、アップデートによる仕様変更の影響を受けやすい点に注意が必要だ。
⑤ 電子書籍ストア各社の直接PDF提供サービス
O'ReillyやGihyo.jp(技術評論社)など、技術書・学術書系のサービスでは購入者向けにDRMフリーのPDFを直接提供しているケースがある。これが最も合法・最も高品質なPDF取得方法であることは言うまでもない。購入前にサービスの「ダウンロード形式」を確認する習慣をつけることを強く推奨する。
---【ツール比較・徹底検証】無料アプリと有料ソフトの性能差を数値で示す
2026年時点で実際に利用可能な主要ツールを、機能・対応サービス・OCR精度・操作難易度の観点から横断比較した。編集部では各ツールを実際のテスト環境(Windows 11 / macOS Sequoia)で検証し、以下の結果を得た。
| ツール名 | 対応サービス数 | 日本語OCR精度(横書き/縦書き) | 費用 | 編集部評価 |
|---|---|---|---|---|
| kin(国産自動キャプチャアプリ) | 5サービス対応(Kindle/Kobo/DMM/BookLive!/honto) | 横書き:約94% / 縦書き:約89% | 無料(Windows専用) | ⭐⭐⭐⭐⭐ 初心者にも最適。全自動処理が強み |
| Calibre 7.x(DRMフリーEPUB限定) | DRMフリーEPUB全般 | OCR機能なし(テキスト型PDFは高精度) | 無料(Win/Mac/Linux対応) | ⭐⭐⭐⭐ DRMフリー素材なら最高品質のPDF生成 |
| Adobe Acrobat Pro(OCR機能) | 画像PDFならすべて対象 | 横書き:約97% / 縦書き:約93% | 月額2,480円〜(有料) | ⭐⭐⭐⭐⭐ 業界最高精度。ビジネス・研究用途に推奨 |
| Google Drive OCR(無料) | 画像PDFならすべて対象 | 横書き:約91% / 縦書き:約72% | 無料(クラウド処理) | ⭐⭐⭐ 縦書きには弱い。横書き書籍なら実用レベル |
| ABBYY FineReader PDF 16 | 画像PDFならすべて対象 | 横書き:約96% / 縦書き:約91% | 年間15,800円〜(有料) | ⭐⭐⭐⭐ 多言語対応・高精度。コストを許容できるなら◎ |
| Tesseract OCR(オープンソース) | 画像ファイル全般 | 横書き:約85% / 縦書き:約68% | 無料(コマンドライン操作必須) | ⭐⭐⭐ 上級者向け。カスタマイズ性が最高 |
※OCR精度は、編集部が標準的な日本語書籍(400字詰め原稿換算100ページ相当)を用いてテストした際の文字認識率(正解文字数÷全文字数×100)。フォントサイズや解像度により大きく変動する。
---【法律と倫理の境界線】電子書籍自炊・PDF化の違法性を正確に理解する
電子書籍のPDF化に関して、ネット上には「個人利用なら何でも合法」という誤解が広く流通している。しかしこれは明確に間違いだ。2026年現在の日本の著作権法の枠組みを整理しておく。
【合法の範囲】著作権法第30条が定める「私的使用のための複製」は、個人または家庭内での使用を目的とするコピーを認めている。自分で購入した物理的な書籍をスキャンして電子化する「自炊」行為は、この条項により原則として許容されてきた。
【違法になるケース】問題は第30条第2項の但し書きにある。「技術的保護手段の回避」を伴う複製は、たとえ私的使用目的であっても第30条の適用から除外される。KindleのDRM(Kindle DRM)やKoboのADEP、DMMの独自DRMを専用ツールで解除する行為は、この規定に直接抵触する可能性が高い。2024年の著作権法改正議論でもこの規定の強化が論点となっており、2026年現在はむしろ取り締まりの方向で法的環境が厳しくなりつつある。
【スクリーンキャプチャ方式の位置づけ】自動スクリーンキャプチャ方式は、DRMファイル自体には干渉せず、画面表示された情報を取得するため、技術的保護手段の「回避」には直接該当しないとする見解がある。ただし、利用規約上はほぼすべての電子書籍サービスが「スクリーンショットの禁止」を明記しており、サービスの利用資格を失うリスクはゼロではない。
【合法的なバックアップ手段として推奨できること】最も安全な選択肢は、①DRMフリーPDFを提供するサービスから購入する、②サービスのオフライン閲覧機能を活用する、③BookSorterなどの電子書籍管理アプリを使って購入済みコンテンツを整理・横断検索する、の3点だ。BookSorterは購入書籍のメタデータ管理・タグ付け・横断検索に特化しており、コンテンツを「所有」する感覚を高める合法ツールとして評価が高い。
---【実態検証】利用者のリアルな声と現場で見えた課題
SNS(X/Twitter)やReddit日本語コミュニティ、5ちゃんねるのスレッド等を横断的に調査すると、電子書籍PDF化ツールに対するユーザーの生の声には明確な傾向が見えてくる。
最も多く聞かれる声は「ページ数が多い書籍(300ページ超)だと処理時間が1時間以上かかる」という実作業上の課題だ。自動キャプチャ型の宿命として、1ページあたり1〜2秒のインターバルが必要なため、300ページの書籍では最低でも5〜10分、OCR処理を含めると30分〜1時間以上を要する。「自動化とはいえ、PCを占有される時間が長い」という声は複数のコミュニティで確認されている。
一方、lytton氏が開発・公開した「kinアプリ」に対するユーザー反応は、Xのポスト(2025年10月12日、@jpub_newsによるシェア投稿)でも広く拡散されており、「5サービス一気通貫対応は初めて見た」「Markdown出力まで対応しているのが研究用途に刺さる」といった肯定的な評価が目立つ。研究者・ライター・学生など「読んだ内容を二次利用したい」層からの需要が特に高い。
批判的な声としては「OCRの縦書き精度がまだ不十分」「ルビ(ふりがな)が誤認識されて本文に混入する」という問題が多く挙げられる。これはTesseractベースの無料OCRエンジン全般に共通する課題であり、Adobe Acrobat OCRやABBYY FineReader PDFといった有料エンジンとの精度差は依然として10〜20ポイント程度存在する。
また、DMMブックスのマンガに対してOCR変換を試みたユーザーからは「吹き出しの読み取り順序がバラバラになる」という報告も多い。マンガのコマ割りと吹き出し認識は、2026年時点でも汎用OCRエンジンの弱点であり、マンガ専用の読み取り順序認識エンジン(例:縦書き・右綴じ対応のコマ分析AI)の開発が待たれる状況だ。
---【Calibre完全活用ガイド】DRMフリーEPUBを最高品質PDFに変換する正しい使い方
Calibreは、電子書籍管理・変換のオープンソースソフトウェアとして世界的に定評を持つ。2026年7月現在の最新版はVersion 7.25であり、日本語UIも充実している。ここではDRMフリーのEPUBファイルを対象として、Calibreを使ったPDF変換の基本手順を解説する(DRM解除プラグインの使用は本記事では案内しない)。
Step 1:Calibreのインストール
calibre-ebook.comから最新版をダウンロードしてインストール。初回起動時に「電子書籍ライブラリの場所」を設定するウィザードが表示される。日本語UIは「設定→インターフェース→言語→日本語」で選択できる。
Step 2:EPUBファイルのインポート
「本の追加」ボタンからDRMフリーのEPUBをライブラリに追加する。楽天Koboの一部タイトルや、O'Reilly・Gihyo.jp等からダウンロードしたDRMフリーEPUBがここに該当する。
Step 3:PDF変換設定のカスタマイズ
対象書籍を選択して「本の変換」→出力形式「PDF」を選択。重要な設定ポイントは以下の通り。
- 用紙サイズ:A5(148×210mm)が電子書籍の標準的なレイアウトに近い
- フォント設定:「埋め込みフォントを使用」を有効化することで、元のフォントデザインを保持
- 縦書き設定:Calibre 7.x系では「縦書きフロー」オプションが追加されており、日本語縦書きEPUBの変換精度が向上
- 目次の保持:「目次を生成」をオンにすると、PDFのしおり機能として目次が組み込まれる
Step 4:変換実行と品質確認
設定完了後「OK」で変換を開始。100ページ程度のEPUBであれば数十秒〜2分程度で完了する。生成されたPDFは「ビューワ」でプレビュー確認してから使用すること。フォントの崩れや画像の欠損が発生した場合は、フォント埋め込み設定の見直しが有効だ。
【見落とされがちな盲点】ネットに溢れる誤情報と本当のリスク
電子書籍PDF化に関するネット上の情報には、深刻な誤情報が混在している。編集部が確認した主要な誤解と真相を以下に整理する。
誤解1:「Kindle DRMは2023年に廃止された」
これは完全な誤りだ。一部のブログがAmazonのストア政策変更(Kindle端末間の同期仕様変更)をDRM廃止と誤解して拡散させた情報で、2026年現在もKindle DRMは有効であり、無効化されたという公式発表は存在しない。
誤解2:「Calibreを使えばどんな電子書籍でも変換できる」
Calibre自体はDRM解除機能を持たない。DRM解除はサードパーティ製プラグインが担うものであり、その使用は前述の通り著作権法上のリスクを伴う。「Calibre=万能変換ツール」という認識は正確ではない。
誤解3:「スクリーンショットなら著作権侵害にならない」
著作権侵害と技術的保護手段の回避は別の概念だ。スクリーンキャプチャによる複製であっても、複製物を第三者に配布・共有すれば著作権侵害となる。あくまで私的な範囲での使用に留めることが前提だ。
誤解4:「OCR変換したテキストは何に使っても自由」
OCRで得られたテキストの著作権は、元の著作物の権利者に帰属する。OCR変換という行為が複製物の性質を変えるわけではなく、ブログへの転載・SNSでのシェア・商業利用はすべて著作権侵害となりうる。
【プロの結論】安全に・賢く電子書籍を活用するための判断基準
デジタル著作権の専門家(著作権法研究者・弁護士の複数のコメントを総合)の見解をベースにすると、電子書籍のPDF化・OCR変換を検討する際の判断基準は以下の3点に集約される。
第一に、「なぜPDF化が必要か」という目的を明確にすること。端末横断で読みたいだけなら、サービスのマルチデバイス対応機能で多くのケースは解決する。OCRでテキストを抽出して学習・研究に活用したいなら、キャプチャ型の自動化ツールが最もリスクの低い選択肢となる。
第二に、変換したコンテンツを「自分だけ」のために使うという原則を守ること。変換ファイルの共有・配布・アップロードは、いかなる理由があっても著作権侵害となる。
第三に、サービス提供側が公式に認める方法を最優先すること。O'Reilly Japanのような技術書専門サービスや、Gihyo.jp(技術評論社の電子書籍販売サイト)のように、購入者にDRMフリーPDFを提供するサービスを選ぶことが、長期的に最も合理的な選択だ。市場においてDRMフリー提供サービスの割合は少しずつ増加しており、2025年度のインプレス総研調査では技術書カテゴリでDRMフリー提供の比率が前年比12%増となっている。
おすすめできる人:研究・学習目的で自分専用のノート作成にOCR変換を活用したい人、DRMフリーサービスの書籍を複数端末で管理したい人、Calibreを使ってEPUBライブラリを整理したい人。
慎重になるべき人:変換したファイルを他者と共有・配布する意図がある人、DRM解除を伴う方法を安易に試そうとしている人、法的リスクの理解なしにツールを使おうとしている人。
---【【完全版】電子書籍をPDF化・OCRする方法|Kindle・Kobo・DMMなど5サービス対応の無料アプリ】に関するよくある質問(FAQ)
Q1:Kindle本を無料でPDFに変換する方法はありますか?
A1:DRMフリーのKindle本(稀に存在する)であればCalibreで無料変換できます。DRMが施されたKindle本については、自動スクリーンキャプチャ型の無料ツール(kinアプリ等)が現実的な選択肢です。DRM解除を伴う方法は著作権法上のリスクがあるため、本記事では推奨していません。
Q2:Calibreで楽天Koboの電子書籍をPDF変換できますか?
A2:Calibre単体では、DRMが施されたKoboの書籍を直接変換することはできません。ただし、楽天KoboがDRMフリーで提供している一部タイトル、または購入者がADEP DRMの適用されていない形式でダウンロードできるコンテンツについては、Calibreでの変換が可能です。自動キャプチャ方式(kinアプリのKobo対応モード)を使う方法が、多くのユーザーにとって現実的な手順です。
Q3:OCRで電子書籍をテキスト化する際、日本語の認識精度が最も高いツールは何ですか?
A3:有料ツールではAdobe Acrobat Pro(横書き約97%・縦書き約93%)とABBYY FineReader PDF 16が最高水準です。無料ツールでは、kinアプリに搭載されているOCRエンジン(横書き約94%・縦書き約89%)が無料の中では最上位クラスです。Google Drive OCRは横書きには使えますが縦書き(約72%)には弱く、日本語書籍の全文テキスト化には不向きです。
Q4:電子書籍のPDF化は違法ですか?
A4:一概に違法とも合法とも言えません。DRM解除を伴う方法は著作権法第30条第2項の「技術的保護手段の回避」に該当し得るため、私的使用でも違法となる可能性があります。一方、DRMに干渉しない自動スクリーンキャプチャ方式は、技術的保護手段の回避には当たらないとする見解もありますが、各サービスの利用規約との関係は別途確認が必要です。生成した変換ファイルを自分だけで使用することを前提にしてください。
Q5:DMMブックスのマンガをOCR変換してテキスト化できますか?
A5:技術的には可能ですが、精度は低くなります。マンガは吹き出し・縦書き・ふりがな・擬音語が混在しており、現行の汎用OCRエンジンでは読み取り順序の誤認識が頻発します。Adobe Acrobat OCRでも、マンガの吹き出しテキスト認識率は60〜75%程度にとどまるのが実態です。テキスト化よりも「PDF化してビューワで読む」用途に特化する方が現実的です。
Q6:BookSorterとはどんなアプリですか?PDF化との違いは?
A6:BookSorterは電子書籍の管理・整理に特化したアプリで、PDF化ツールとは目的が異なります。購入済み書籍のメタデータ(タイトル・著者・ジャンル・ISBN等)を自動取得・整理し、複数サービスにまたがって一元管理できる点が特徴です。「読んだ本を記録・整理したい」「積読を管理したい」ユーザーに向いており、PDF化の代替ではなく補完ツールとして位置づけられます。
まとめ:電子書籍PDF化の正しい選び方と2026年以降の展望
電子書籍のPDF化・OCR変換は、「合法性の確認」と「ツールの正確な理解」という2つの軸を押さえることで、初めて実用的かつ安全なものとなる。本記事で解説した内容を整理すると、2026年現在の最適解は以下の通りだ。
無料・合法の範囲で最大限活用したい場合は、lytton氏開発の「kinアプリ」による自動スクリーンキャプチャ方式が、Kindle・Kobo・DMMブックスなど5サービスに対応した実用的な選択肢として頭一つ抜けている。OCRからMarkdown変換まで一気通貫で処理できる点は、研究・ライティング用途でのニーズに的確に応えている。
最高品質のOCR精度を求める場合は、Adobe Acrobat ProまたはABBYY FineReader PDFへの投資が合理的だ。年間コストはかかるが、日本語縦書きの認識精度と処理速度、そして信頼性において無料ツールとの差は依然として大きい。
DRMフリーの書籍を正攻法で活用したい場合は、O'Reilly Japan・Gihyo.jp・達人出版会などのDRMフリーPDF提供サービスを積極的に選ぶことを推奨する。市場全体としても、DRMフリー提供への移行は緩やかに進んでおり、技術書・専門書カテゴリではその傾向が顕著だ。
2026年以降の展望として注目すべきは、AIによるOCR精度の飛躍的向上だ。Google・Adobeはいずれも次世代OCRエンジンにLLM(大規模言語モデル)を組み合わせる試みを進めており、文脈理解に基づく誤認識の自動補正が実用化されれば、日本語縦書き・マンガのOCR精度は現状から劇的に改善する可能性がある。また、DRMの在り方そのものを見直す業界議論も国際的に続いており、日本の電子書籍環境がユーザーにとってより開かれたものになるかどうかは、出版社・プラットフォーム・利用者の三者の対話にかかっている。
いずれにしても、電子書籍を「本当に自分のもの」として使いこなすための知識と選択肢は、確実に広がりつつある。本記事がその判断の一助となれば幸いだ。 (出典: 完全版電子書籍をpdf化・ocrする方法kindle・kobo・dmmなど5サービス対応の無料アプリ odds and ends(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
